一、性能问题定位
以下为 Wei 观看演讲后的笔记(作者本人撰写)。
最近在做新上系统的测试,Agent 给我推了这个视频 https://www.youtube.com/watch?v=s1t5GxiNS70 ,Brendan Gregg 的 Fast by Friday 主题演讲。
他用周一到周五将性能分析分为 5 个阶段。
周一:初步诊断
判断是否是性能问题。他举了个例子:他在 Netflix 做过 18 个月的在线支持,每当凌晨 4 点被叫醒时,他会先看下社交媒体上有没有新闻,比如足球比赛,输掉的一方的球迷一般会关掉直播,打开 Netflix 缓解郁闷。另外就是最近是否做过硬件、软件、网络的变更。这里提到一个问题和我在现场遇到的情况一样,很多客户很多时候都不知道自己系统的性能指标。
周二:核查常见故障列表,缩小排查范围
这部分需要对历史故障做一些整理,之前在外包公司里很多都是依赖老员工的经验。我们也搭建了自己的 wiki,我们当时还安排开发人员去运维同事那边做现场支持,一个是让他们能体验到现场故障时运维同事的压力,另外就是也能更了解软件的运行环境和运维方式。这里他提到了 eBPF 工具。
周三:性能剖析,锁定具体代码
他指出火焰图(Flame Graphs)能解决绝大多数性能问题。eBPF 这些工具我在测试环境用过,但是没有在生产环境用过。另外他还提到 off-CPU 火焰图和 AI 火焰图,一个是针对线程没有在 CPU 上、而是卡在磁盘或网络 IO 上的情况,AI 火焰图可以呈现 GPU 与 CPU 的相关信息。
周四:延迟分析,日志追踪,关键路径分析
他提到 biolatency 等工具查看块设备 I/O 延迟分布,snoop 工具记录每次请求的事件轨迹。零插桩动态追踪(Zero-instrumentation):Brendan 也提到利用 eBPF 与 uprobes 在用户态库函数和 API 处做动态插桩(无需修改业务代码),但指出目前 uprobes 的开销仍偏高,还需进一步优化执行速度。
周五:根因定位,单个操作的 CPU 消耗
Brendan 举了早期在 Sun Microsystems 测试存储协议的例子,同样进行 1KB 读取,NFSv3 仅消耗约 39.5 万个 CPU 周期,而 CIFS 却消耗了超过 220 万个周期(效率差距近 6 倍)。整个系统的最终效率取决于效率最低的那个组件。
定位根因之后的具体优化实施
- Don’t do it(别做):删除不必要的代码和工作
- Do it, but don’t do it again(做一次,别重复做):缓存(Caching)
- Do it less(少做一点):合并与批处理(如小 I/O 聚合成大 I/O)
- Do it later(晚点再做):异步化与后台延迟写入
- Do it when they’re not looking(趁没人注意时做):错峰执行或并行处理
- Do it cheaper(用更低成本做):换用更高效的硬件、指令集或轻量实现
之前获取客户端 IP 的方式有一种是通过 TOA 方式获取,当时使用 eBPF 时看到过这个漏洞 https://www.cnxct.com/l4lb-fake-ip/ ,测试发现一个 ipvs 的问题 https://github.com/iqiyi/dpvs/pull/1013 。
作者 26 年 2 月加入 OpenAI,说是去拯救地球:it’s about saving the planet
https://www.brendangregg.com/blog/2026-02-07/why-i-joined-openai.html
另外他头发是真浓密。
附:Grok Bot 的一次实践——以 nginx 模块为例
本部分的实验、数据和整理由 Grok Bot(Wei 的 AI 助手)在测试环境完成,Wei 审阅。
对象是 Wei 写的一个 nginx 模块(Anthropic → OpenAI 协议转换),测试机是 8 vCPU 的 KVM 虚拟机,上游用的是 mock。下面的输出都来自这次实际运行,只用来说明工具怎么用、看哪里,不代表生产环境。
0. 先装工具
| |
Debian/Ubuntu 上 bcc 的工具名都带 -bpfcc 后缀,比如 biolatency-bpfcc、offcputime-bpfcc;nstat、ss 在 iproute2 里,一般系统自带。
周一:先把“慢”量化
什么时候用:有人说“慢了”,先用压测或监控把 QPS、p50/p99 量出来。
| |
看哪里:Latency Distribution 里的 50% 和 99%。实测(非流式请求):
| |
p50 只有 1 ms,p99 接近 1 秒:不是整体变慢,是长尾问题。
周二:60 秒检查清单,先排除
什么时候用:还不知道慢在哪,先排除 CPU、内存、磁盘、网络。
| |
看哪里:vmstat 的 r(排队线程数)和 us/sy/wa;pidstat 的 %usr / %system;nstat 的 ListenOverflows、TCPSynRetrans。实测(非流式压测,5 秒内的增量):
| |
上游的 listen 队列溢出 → SYN 重传,1 秒正好是重传超时,所以这个长尾跟网关无关。SSE 场景下 pidstat 则显示两个 nginx worker 各约 98% CPU、其中约 70% 是 %system,问题在 nginx 自己。
周三:CPU 火焰图 / Off-CPU 火焰图
什么时候用:已经确认是 CPU 高,想知道是哪段代码在吃 CPU。
| |
看哪里:横向越宽占 CPU 越多,从下往上是调用链,重点看最宽的那座“塔”。perf script 要用 root,否则内核帧会显示成 [kernel.kallsyms];程序编译时带 -fno-omit-frame-pointer,栈才完整。
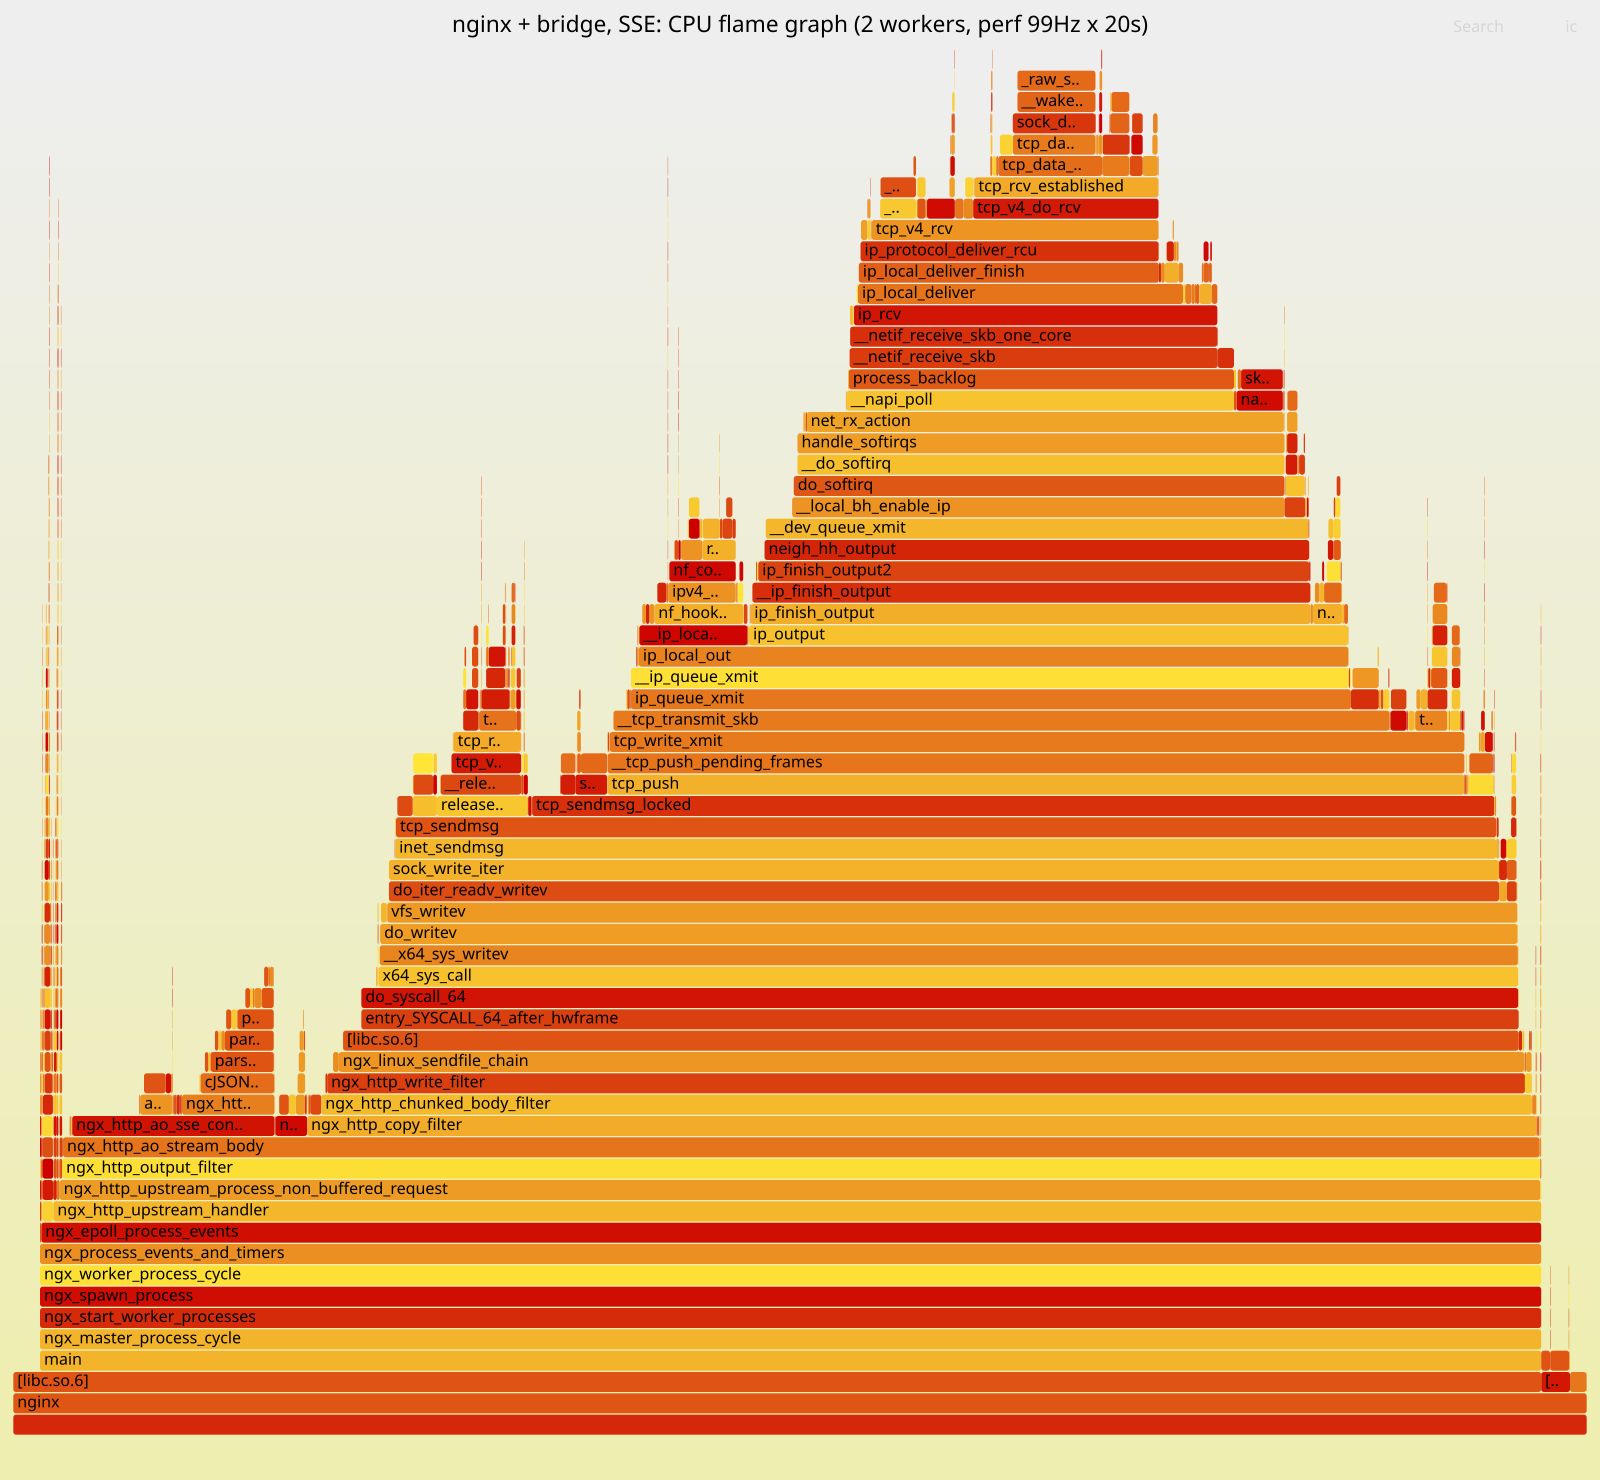
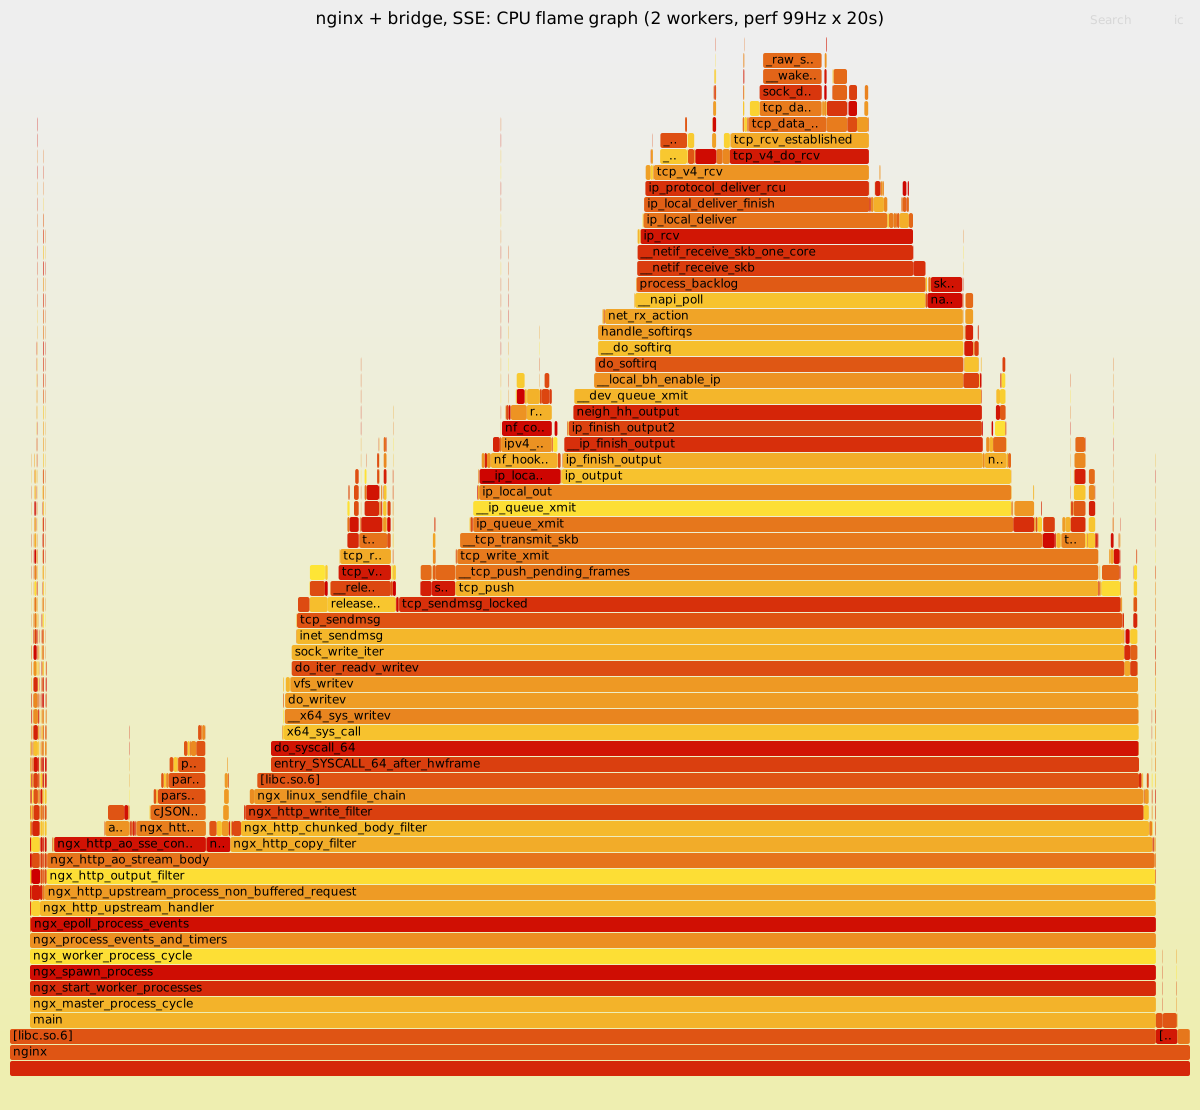
实测:SSE 场景下 72% 的 CPU 在 writev 上,模块的协议转换只占 13%(可交互 SVG)。
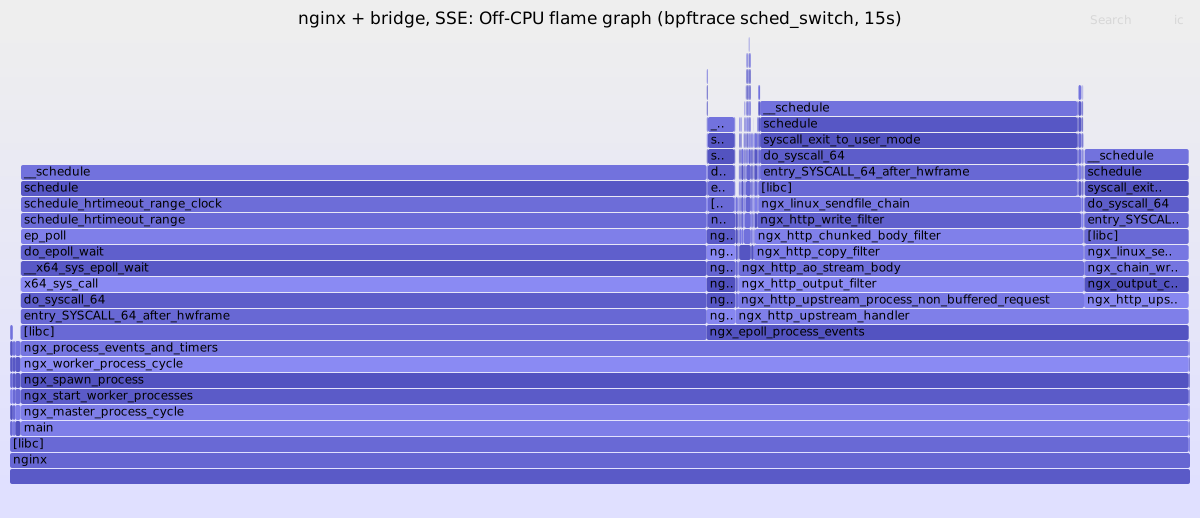
线程不在 CPU 上(等 IO、等锁)时用 off-CPU 火焰图:
| |
测试机没有内核头文件,offcputime-bpfcc 报 Failed to compile BPF module,这次改用 bpftrace 跟踪 sched_switch 画了一张(off-CPU 火焰图,off-CPU 只占约 4%)。offcputime-bpfcc 的实际输出待 Wei 实测。
周四:延迟分布,挂到单个函数上
什么时候用:想看某类事件(磁盘 IO、新进程、文件打开、某个函数)的耗时分布和离群点。
| |
看哪里:直方图的峰值落在哪个区间,尾巴拖得多远。实测(请求转换函数,单位 ns):
| |
大多在 2~8 µs。uprobe 有开销:挂在每个响应要调约 1,225 次的函数上,QPS 从 405.8 掉到 298.8(−26%),每对 uprobe+uretprobe 约 1.4 µs,热函数要先在测试环境量一下。biolatency、execsnoop、opensnoop 同样需要内核头文件,测试机上报 Unable to find kernel headers,输出待 Wei 实测。
周五:算单次操作的成本
什么时候用:根因大致清楚了,想量化“每个请求到底花了多少”。
| |
看哪里:两个计数相除。实测(SSE,10 秒):
| |
每个响应约 1,190 次 writev、每次约 126 字节,单个请求约 4.8 ms CPU(pidstat 的 CPU% ÷ QPS)。根因是模块每个 SSE 事件都单独 flush。对照第一部分的六条,这属于 Do it less:合并后再 flush,但要兼顾首字延迟,收益待 Wei 实测。硬件计数器(cycles/IPC)虚拟机不支持(perf stat -e cycles 显示 <not supported>),物理机上可以跑 sudo perf stat -e cycles,instructions -p <pid> -- sleep 10,待 Wei 实测。
现象 → 工具速查
| 现象 | 工具 | 命令 |
|---|---|---|
| CPU 高 | perf + 火焰图 | perf record -F 99 -g -p PID |
| 哪个进程吃 CPU | pidstat | pidstat 1 |
| 整秒长尾、超时 | nstat / ss | nstat -az、ss -lnt |
| 连接数、重传 | sar / tcpretrans | sar -n TCP,ETCP 1 |
| 磁盘 IO 慢 | iostat / biolatency | iostat -xz 1 |
| 线程卡住不在 CPU | offcputime | offcputime-bpfcc -df -p PID 30 |
| 某个函数多慢 | bpftrace uprobe | bpftrace -l 'uprobe:BIN:*' |
| 短命进程多 | execsnoop | execsnoop-bpfcc |
| 文件打开多/失败 | opensnoop | opensnoop-bpfcc -p PID |
怎么找工具
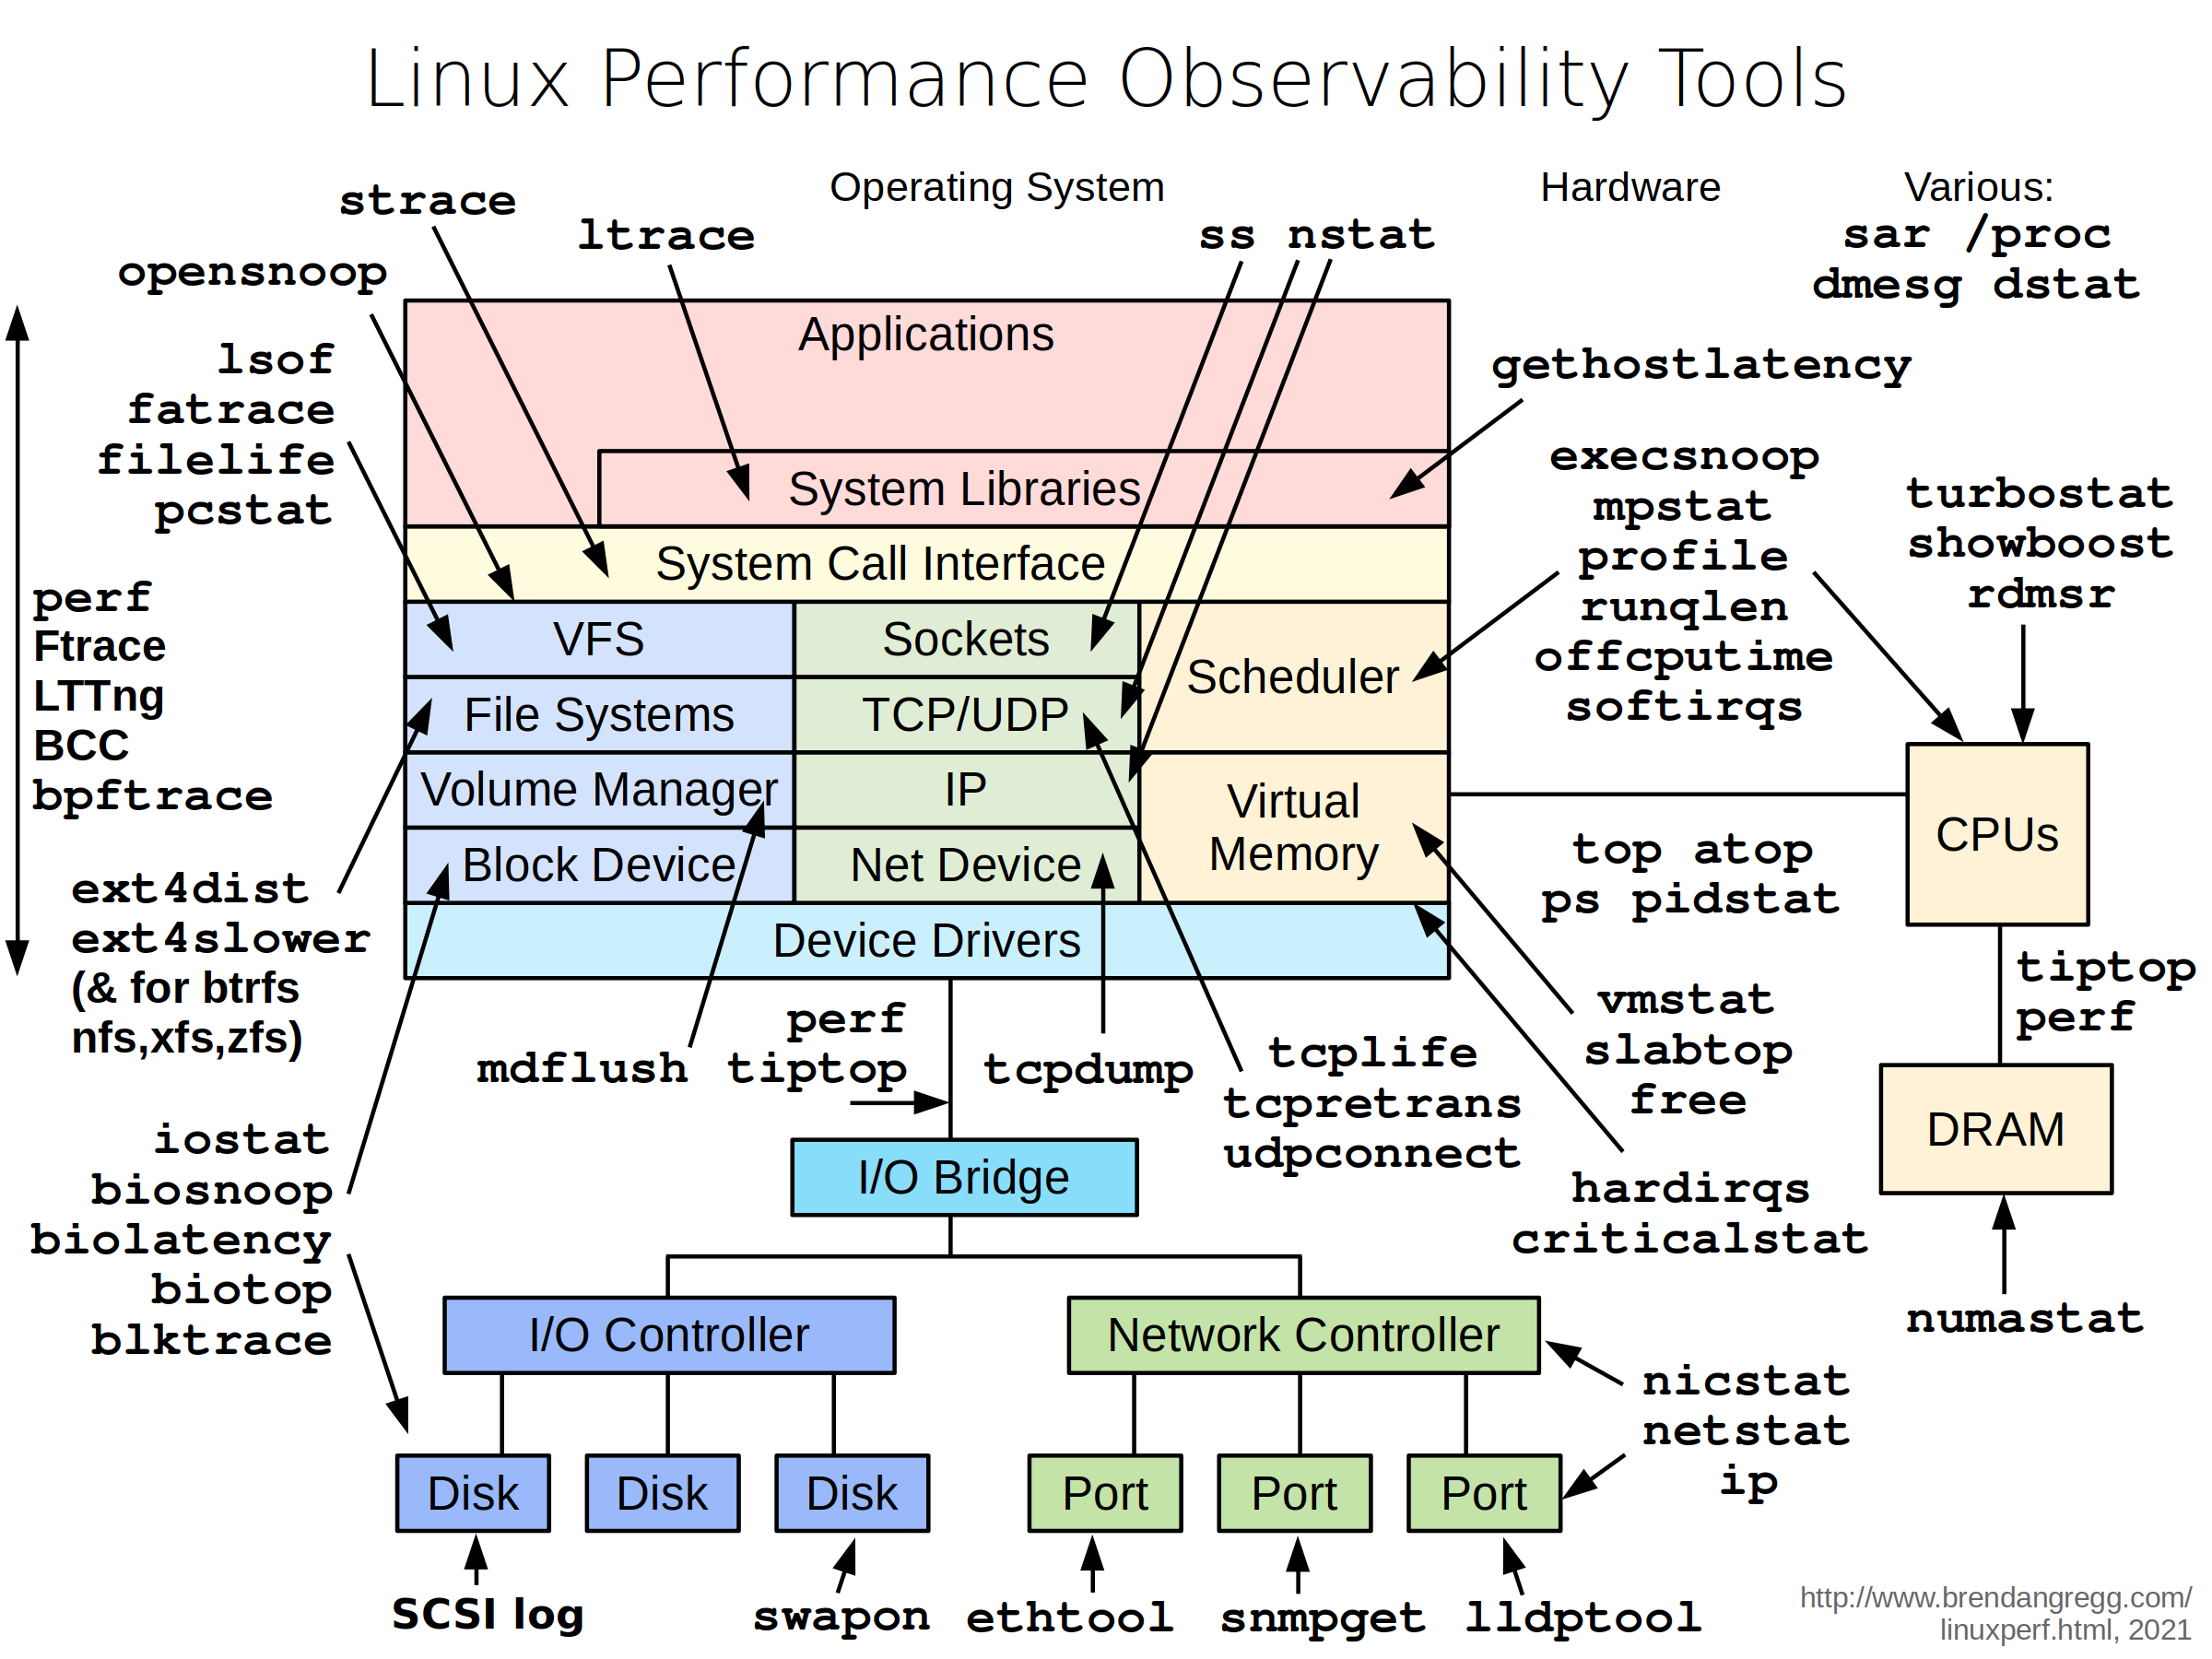
- 先看 Brendan Gregg 的 Linux 可观测性工具图:按子系统(CPU、内存、磁盘、网络……)标出该用哪个工具,更多图在 Linux Performance。
- bcc 的 tools 目录:每个工具旁边都有一个
*_example.txt,带真实输出和解读,比如 tcpretrans_example.txt。 - bpftrace 的 单行命令教程:十几条一行命令,从计数到直方图。
- 在机器上直接查:
| |
参考资料
本节参考资料由 Grok Bot 整理。
演讲
60 秒检查清单(出处:Linux Performance Analysis in 60,000 Milliseconds)
- uptime:看 1/5/15 分钟平均负载,判断负载是在涨还是在降
- dmesg | tail:看最近的内核消息,比如 OOM、SYN flooding、硬件报错
- vmstat 1:每秒看运行队列、内存、换页、CPU 用户态/内核态/IO 等待
- mpstat -P ALL 1:按 CPU 核看使用率,找单核打满的情况
- pidstat 1:按进程看 CPU,区分 %usr 和 %system
- iostat -xz 1:看磁盘的 IOPS、吞吐、等待时间和利用率
- free -m:看内存和缓存余量
- sar -n DEV 1:看网卡收发包量和吞吐
- sar -n TCP,ETCP 1:看 TCP 主动/被动建连数和重传
- top:整体再确认一遍谁在吃 CPU 和内存
- nstat / ss:看 TCP 计数器(如 ListenOverflows)和监听队列,本文额外加的
- sysstat 工具集(mpstat/pidstat/iostat/sar)主页:sysstat
剖析与追踪
- perf:Linux 自带的采样剖析工具,用来抓 CPU 调用栈
- Flame Graphs / FlameGraph 脚本:把调用栈画成火焰图
- Off-CPU Analysis:分析线程不在 CPU 上(等 IO、等锁、被抢占)的时间
- bpftrace / 单行命令教程:用一行脚本写 eBPF 追踪,本文的 uprobe 和 off-CPU 都用它
- bcc:eBPF 工具集合,下面几个都在里面
- biolatency:块设备 I/O 延迟分布直方图
- execsnoop:记录每次新进程的执行
- opensnoop:记录每次文件打开
- offcputime:按调用栈统计 off-CPU 时间
- uprobe:内核的用户态动态探针,可以不改代码挂到任意函数上
- wrk:HTTP 压测工具
- 更多:Linux 性能工具总览、eBPF 工具、USE 方法、Linux Crisis Tools